2026 年 10 月 15 日,阶跃星辰负责开源新一代旗舰模子 Step 5 Preview,在 AI 编程、软件工程、专科学问责任、金融等任务上达到前沿水平。
这次 Step 5 Preview 也曾开源发布,昇腾就基于 vLLM 推理引擎兑现了 0Day 支执,并围绕模子架构与硬件脾气兑现了高效推理优化。
华为与阶跃星辰执续久了配合,10 月 15 日首套 1024 卡 Atlas 950 SuperPoD 液冷超节点点亮,为 Step 系列大模子提供算力就业,性能执平国际先进算力。
Step 5 Preview:万能前沿,架构纠正
Step 5 Preview 吸收稀少 MoE 架构,总参数目 600B,每个 Token 激活 27B 参数,支执 1M Token 凹凸文窗口和图像、视频的多模态输入。
同期,Step 5 Preview 在软件工程、Agent、专科责任和金融等多个方朝上齐取得了有竞争力的进展。
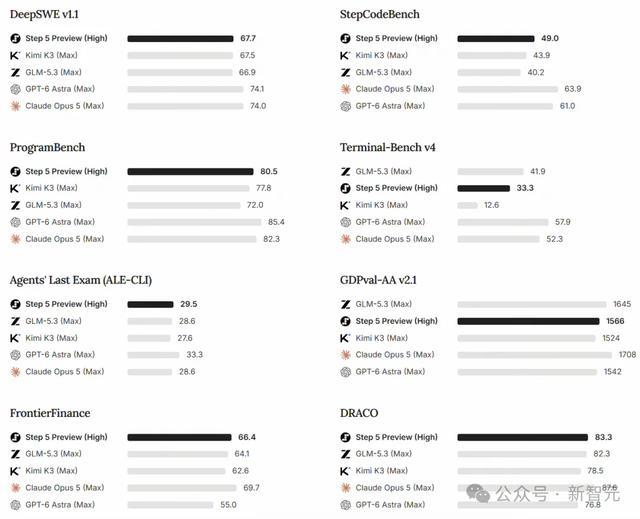
Step 5 Preview 与主流前沿模子在 Agentic Benchmark 上的性能对比
Step 5 Preview 吸收了全新的 Sparse Attention 结构,支执 1M Token 凹凸文窗口,先通过 Indexer 遴选 Token,在选中 Token 的鸿沟内计较 Self Attention。
为了处治 Index 计较瓶颈的问题,通过以 Region(8 个 Token)为单元压缩 Indexer Key 兼顾抑止与性能。
首套 1024 卡昇腾 950 液冷超节点点亮
10 月 15 日,首套 1024 卡 Atlas 950 SuperPoD 液冷超节点跟着 Step 5 Preview 的开源同步上线点亮。
昇腾 Atlas 950 SuperPoD 液冷超节点基于灵衢高速互联架构与超节点技能体系打造,是业界范畴最大的 1024 卡超节点居品,可提供 1 EFLOPS FP8、2 EFLOPS FP4 精度滂湃算力,高效适配万亿参数大模子的推理场景需求。
昇腾 950 超节点具备 256TB 全局妥洽内存编址智力、NPU 卡间达 TB 级互联带宽、时延低至 3μs,透澈冲破传统集群内计较与存储资源的通讯瓶颈;通过系统性架构转变与全域资源妥洽相易,兑现了整套集群算力的高效开释与结识开动。
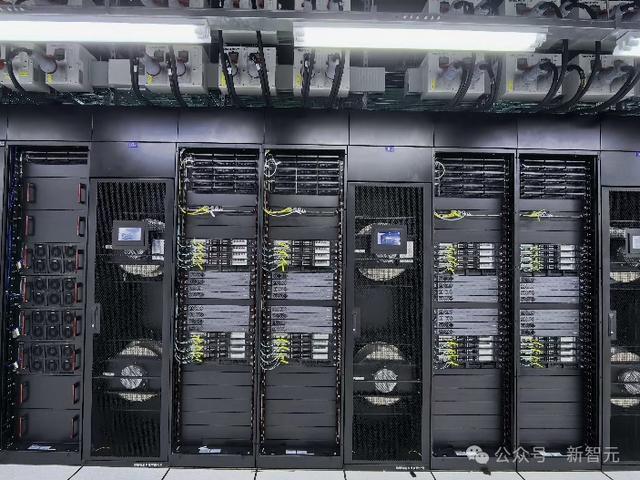
首套 1024 卡昇腾 Atlas 950 SuperPoD 液冷超节点点亮
阶跃星辰将与昇腾执续探索大模子推理的性能极限,挖掘模子落地应用价值,共同践行「智能阶跃,十倍每一个东谈主的可能」的发展愿景。
昇腾:软硬协同优化,
开释 950 超节点重大推理潜能
昇腾基于 vLLM Ascend 推理引擎,围绕 Step 5 Preview 模子架构与 950 超节点硬件脾气,协同构建高效的推理优化有野心。
从 Ascend C 与 Triton 交融算子,到多流并行、计较空泡优化,再到 MTP 投契解码、NPU Graph 图实施,执续买通模子、算子和推理框架之间的优化链路,为 Step 5 Preview 部署提供高效算力撑执。
算子优化:Ascend C 与 Triton 协同,兼顾极致性能与成立抑止
针对 Step 5 Preview 的稀少谨防力、模子勾通结构与夹杂巨匠集聚,昇腾纠合 CANN 算子智力与 Triton 编程将散播的计较和数据处理兑现高效实施。
1、IndexerLogits 与 SparseAttn Ascend C 算子: 昇腾 950 超节点新增 FP8 算力,支执 IndexerLogits 的原生 FP8 计较,通过将 Token 打分与 TopK、Sort 等 Token 筛选的经由交融为 Indexer Logits Ascend C 算子,使用成对 Region 搬移普及搬运带宽;借助 SparseAttn 算子使用 Vector 单元的 SIMD 智力替代 Scalar 运算。
2、Triton 交融 Kernel 加快:围绕 Norm、Indexer key 压缩,兑现重要交融算子(QK Norm、Index Key 压缩等)优化,通过添加 AutoTune,自动寻优昇腾亲和的 Tiling 大小,使能 950 超节点中的 SIMT 智力,通过 QK Norm 交融和 Indexer Key 压缩兑现性能加快。
3、MoE 巨匠路由优化: 围绕 Hash TopK 巨匠遴选,优化路由前处理与精度传递,减少跨层重复操作。
4、MXFP8 量化:昇腾 950 超节点硬件单元兑现了 MXFP8 的反量化,通过再行量化权重为 MXFP8 设施,在精度真实无损的情况下极致阐扬 950 超节点的硬件算力。
从中枢谨防力到巨匠路由,从交融计较到数据搬运优化,多脉络算子协同使 Step 5 Preview 的架构脾气与昇腾硬件智力更抽象地纠合。
通讯优化:FullMesh + CLOS 交融架构与算法转变,大幅普及通讯性能
1、FullMesh+CLOS 最大化带宽: 950 超节点不错同期哄骗 FullMesh + CLOS 进行通讯,最大化普及 Allreduce、Allgather、ReduceScatter 等通讯原语的性能。
2、Dispatch Server 级去重,减少跨就业器重复传输: 在昇腾 950 超节点的高朦拢有野心中,吞并 Token 可能被多个巨匠选中,若是这些巨匠位于吞并远端就业器,则通过跨就业器先发送一份主副本,再在就业器内分发,减少重复流量。
面临多个发送方,按组分发任务,纠合并行通谈与批量提交,减少衰败漫送,让数据传输执续鼓动。
3、Combine 通过双缓冲,兑现 Reduce 与通讯回传重迭:巨匠计较完成后,先对吞并输入对应的多份抑止进行局部归并,再按数据块回传。
两个输出缓冲区轮换使用,让上一批抑止回传的同期,下一批继续进行 Reduce(归并),减少归并与回传之间的恭候。
框架优化:序列并行、多流并行、Tiling 下千里协同,减少重复操作与相易支拨
推理抑止不仅取决于算子的实施速率,也取决推理框架何如最猛进程减少重复操作,将没少见据依赖的计较并行,通过图方式和异当作度,减少计较单元的恭候,让各阶段衔尾得更抽象。
1、MoE 序列并行:围绕模子勾通结构、引入序列并行镌汰冗余计较和通讯。
2、Vector/Cube/通讯多流并行:纠合昇腾向量、矩阵计较单元以及通讯单元不错并行实施的脾气,通过多流相易组织计较与访存交叠,减少串行恭候和计较空泡,提高硬件资源哄骗抑止。
3、NPU Graph 图实施优化:将解码阶段的计较纳入图实施,纠合执久化缓冲区和输出复用,减少重复相易、临时辰拨与数据拷贝,使高频解码经由更紧凑。
4、多 Token 展望优化与 Tiling 下千里: 适配 Step 系列模子的多 Token 展望(MTP)机制,普及单步生成抑止。
通过 Attention 算子的 Tiling 下千里,将主模子与草稿模子、每步推理之间的断流摒除,从而减少 Device 空泡,普及开动抑止,并借助 950 超节点的高带宽,兑现极致的高朦拢。
5、Prefill Indexer Key 压缩阶段 Slot 预分拨: 通过将模子内动态搜索可用的 Slot(用于存储 Index Key 压缩后的位置)改为预分拨,摒除了层间的冗余操作。
通过算子实施、图开动与相易计谋的协同联想,适配有野心从多个层面压缩推理经由中的非计较支拨,执续挖掘硬件与模子的性能后劲。
从算子交融到通讯优化、框架优化,昇腾将执续推动 Step 5 Preview 的推明智力向骨子应用周折,为长凹凸文、多模态与智能体场景提供高效算力撑执。
Step 5 Preview 昇腾量化版块推理部署教导
用户及成立者可探望以下畅达获得 Step 5 Preview 昇腾量化版块的推理部署教导开云(中国)Kaiyun·官方网站 - 登录入口,进行体验(骨子性能与部署有野心、参数设置及软硬件环境等身分算计,并将执续优化普及):